From an Idea to Hirevidence.com 🚀
The Story Behind Building an Evidence-Based Candidate Screening SaaS
Ada satu project yang beberapa bulan terakhir cukup sering membuat saya tidur lebih malam.
Namanya Hirevidence.
Dan akhirnya...
Hirevidence.com is live. 🚀
Buat saya, ini bukan sekadar launching sebuah website.
Ini adalah cerita tentang bagaimana sebuah ide kecil berkembang menjadi SaaS yang melibatkan Django, PostgreSQL, Redis, Celery, Docker, PDF extraction, OCR, AI reasoning, background processing, security, CI/CD, dan tentu saja...
banyak error. 😂
Jadi kali ini saya ingin sedikit cerita bagaimana semuanya bermula.
The Problem
Semuanya berawal dari satu pertanyaan sederhana:
Kenapa screening CV masih harus begitu manual?
Bayangkan sebuah perusahaan membuka satu posisi.
CV masuk.
10...
50...
100...
300...
Recruiter kemudian harus membaca CV satu per satu.
Mencari skill.
Membandingkan pengalaman.
Mencocokkan requirement.
Mencatat kandidat yang menarik.
Kemudian kembali lagi ke CV sebelumnya untuk memastikan detail tertentu.
Untuk jumlah kandidat yang besar, proses ini bisa memakan waktu berhari-hari bahkan lebih lama.
Dan ada satu masalah lain.
CV adalah dokumen marketing.
Candidate tentu ingin menampilkan dirinya sebaik mungkin.
"Expert Python."
"Advanced AWS."
"Experienced Kubernetes."
"Strong leadership."
Pertanyaannya bukan apakah tulisan itu ada di CV.
Pertanyaannya:
Apa evidence di baliknya?
The Idea
Dari situ muncul sebuah ide:
Bagaimana kalau kita membuat sistem yang membantu recruiter mencari evidence tersebut secara otomatis?
Bukan untuk menggantikan recruiter.
Bukan untuk mengatakan:
"Candidate A harus diterima."
Tetapi membantu menjawab:
-
Skill apa yang benar-benar memiliki evidence?
-
Seberapa relevan pengalaman tersebut?
-
Mana yang terlihat kuat?
-
Mana yang masih belum jelas?
-
Apa yang tidak ditemukan?
-
Apa yang perlu diverifikasi saat interview?
Konsepnya kemudian berkembang menjadi satu prinsip:
Evidence over assumptions.
Dan dari situlah Hirevidence mulai dibangun.
Prototype Pertama
Versi pertama tentu saja tidak secanggih sekarang.
Pada dasarnya:
Upload CV → extract text → process → tampilkan hasil.
Kelihatannya sederhana.
Ternyata tidak.
CV ternyata bisa datang dalam berbagai bentuk.
Ada PDF text-based.
Ada CV dengan dua kolom.
Ada tabel.
Ada layout yang sangat kompleks.
Ada PDF yang sebenarnya cuma gambar.
Ada CV yang text extraction-nya menghasilkan sesuatu yang... ya...
nggak bisa dibaca manusia. 😂
Jadi saya mulai bermain dengan beberapa tools dan pendekatan untuk extraction.
Di antaranya:
-
PyMuPDF
-
python-docx
-
Pillow
-
Tesseract OCR
Saya akhirnya lebih banyak menggunakan pendekatan text extraction terlebih dahulu untuk dokumen yang memang memiliki text layer, dan menggunakan OCR ketika diperlukan.
Prinsipnya sederhana:
Jangan gunakan OCR kalau sebenarnya text-nya sudah tersedia.
Lebih cepat.
Lebih sederhana.
Dan lebih murah.
Then Things Got Serious
Setelah extraction mulai bekerja, muncul masalah berikutnya.
Bagaimana sistem mengetahui apakah hasil extraction itu benar?
Ini penting.
Misalnya CV berhasil di-upload.
Processing berjalan.
Tidak ada error.
Tetapi ternyata:
name = ""
email = ""
skills = []
experience = []
education = []
Secara teknis...
processing berhasil.
Secara bisnis...
sistem gagal.
Dan ini membuat saya sadar bahwa:
HTTP 200 bukan berarti bisnis proses berhasil.
Saya kemudian mulai memikirkan pipeline yang lebih jelas.
Kurang lebih seperti:
Upload
   ↓
Queued
   ↓
Extracting
   ↓
Extraction QA
   ↓
Screening
   ↓
Explaining
   ↓
Done
Dan jika sesuatu benar-benar gagal:
Failed
Ini kemudian menjadi bagian penting dari architecture Hirevidence.
Extraction QA
Salah satu komponen yang cukup penting akhirnya menjadi Extraction QA.
Tujuannya bukan sekadar memeriksa apakah Python exception terjadi.
Tetapi memeriksa:
"Apakah hasil extraction masuk akal?"
Misalnya:
Candidate Name     ✓
Email              ✓
Experience         ✓
Skills             ✓
Education          ✓
Kalau hasilnya kosong atau tidak lengkap secara tidak wajar, sistem harus bisa mendeteksinya.
Ini juga membawa saya ke satu pertanyaan penting:
Kapan credit user boleh dikurangi?
Kalau user memberikan CV yang memang sangat buruk atau informasinya memang minim, itu berbeda dengan:
sistem kita gagal memproses CV.
Saya tidak ingin user kehilangan credit hanya karena sistem saya sendiri gagal.
Akhirnya saya harus memisahkan antara:
Candidate input problem
dan
System processing failure.
Kelihatannya kecil.
Tapi ketika membangun SaaS yang benar-benar akan dipakai orang, detail seperti ini menjadi sangat penting.
Enter Celery and Redis
Kemudian saya sadar satu hal:
Saya tidak mungkin memproses semuanya secara synchronous.
Bayangkan user upload 100 CV.
Kalau setiap CV diproses langsung dalam HTTP request:
Browser
   ↓
Django
   ↓
Extract CV
   ↓
AI processing
   ↓
Database
   ↓
Response
Itu bukan ide yang bagus.
Maka processing saya pindahkan ke background worker.
Architecture-nya menjadi lebih seperti:
User
 │
 ▼
Django
 │
 ▼
Redis
 │
 ▼
Celery Worker
 │
 ├── Extraction
 ├── Extraction QA
 ├── Screening
 └── Explanation
 │
 ▼
PostgreSQL
Sekarang user tidak perlu menunggu satu request HTTP menyelesaikan seluruh pekerjaan.
Django menerima pekerjaan.
Queue mengatur pekerjaan.
Worker mengerjakan pekerjaan.
Database menyimpan hasilnya.
Jauh lebih masuk akal.
Dan tentu saja... worker juga bisa bermasalah 😂
Ini bagian yang menarik ketika membangun sistem asynchronous.
Kadang web hidup.
Redis hidup.
Database hidup.
Tapi worker tidak melakukan apa yang seharusnya.
Atau worker terlihat hidup...
tetapi ternyata task tidak berjalan seperti yang saya harapkan.
Di sinilah saya mulai belajar bahwa distributed processing punya jenis masalah yang berbeda dari aplikasi web biasa.
Debugging tidak lagi cuma:
print("masuk sini")
Sekarang saya harus bertanya:
Apakah task masuk queue?
Apakah Redis menerima task?
Apakah worker mengambil task?
Apakah task retry?
Apakah task gagal?
Apakah database transaction berhasil?
Apakah status processing berubah?
Dan tiba-tiba satu fitur sederhana berubah menjadi sistem kecil.
Scaling the Test
Setelah pipeline mulai stabil, saya mulai menaikkan jumlah test.
Bukan lagi:
5 CV.
Tapi puluhan.
Kemudian ratusan.
Karena aplikasi yang terlihat bagus ketika digunakan oleh satu user belum tentu bagus ketika digunakan oleh banyak user.
Saya ingin tahu:
"Kalau besok ada recruiter yang upload ratusan CV, apa yang terjadi?"
Pertanyaan itu kemudian memaksa saya mulai memikirkan:
-
queue concurrency
-
worker capacity
-
Redis
-
database load
-
file storage
-
processing time
-
retry mechanism
-
failure handling
-
progress tracking
Dan ini salah satu bagian paling menarik dari membangun SaaS.
Scale membuat architecture decisions menjadi nyata.
AI: Useful, But Not the Boss
Kemudian tentu saja ada AI.
Saya tidak ingin membuat:
CV
 ↓
AI
 ↓
82%
Selesai.
Menurut saya itu terlalu sederhana.
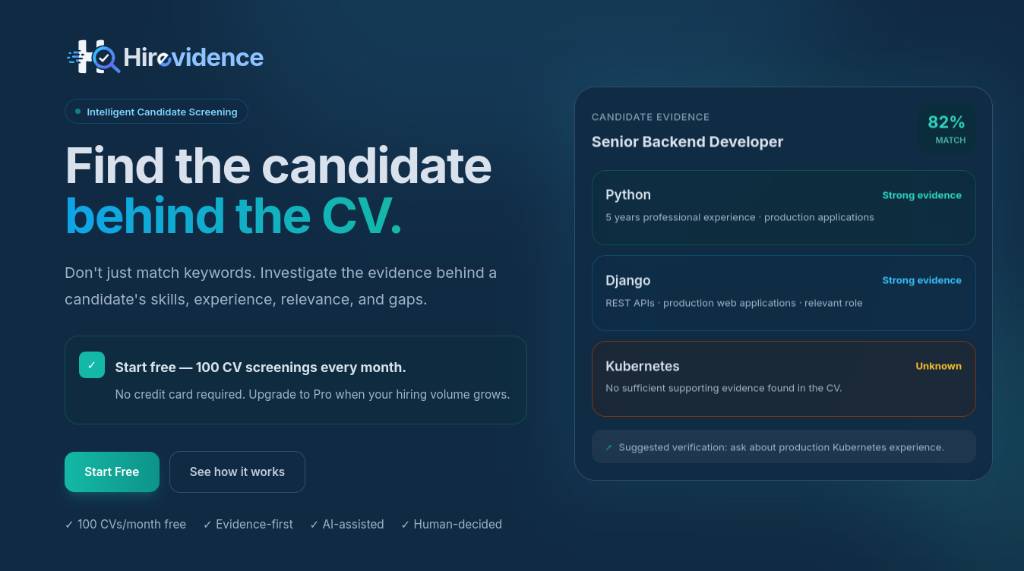
Saya ingin sistem bisa menunjukkan kenapa sebuah skill dianggap relevan.
Misalnya:
Python
Evidence: Strong

Django
Evidence: Strong

Kubernetes
Evidence: Unknown
Bukan:
Kubernetes = 0
Karena tidak disebutkan di CV belum tentu berarti candidate tidak pernah menggunakannya.
Mungkin memang tidak punya pengalaman.
Mungkin juga pernah menggunakan tetapi tidak menuliskannya.
Maka:
Unknown ≠ No.
Ini adalah salah satu prinsip yang cukup penting dalam Hirevidence.
AI digunakan ketika reasoning yang lebih dalam memang diperlukan.
Tetapi hasilnya harus tetap bisa diperiksa oleh manusia.
Human in the Loop
Ini juga alasan kenapa saya tidak ingin Hirevidence menjadi sistem:
"AI decides who gets hired."
Menurut saya, hiring terlalu penting untuk diserahkan begitu saja kepada sebuah model.
Hirevidence lebih diarahkan untuk membantu recruiter mendapatkan informasi.
Sistem memberikan:
-
evidence
-
matching information
-
confidence
-
unknown / missing evidence
-
skill gaps
-
verification questions
Kemudian:
Recruiter yang memutuskan.
Jadi prinsipnya:
Intelligence over prompts.
Evidence over assumptions.
Human decides.
Building the Infrastructure
Setelah aplikasinya mulai serius, infrastructure juga ikut berkembang.
Development environment menggunakan Docker.
Application menggunakan Django.
Database menggunakan PostgreSQL.
Redis digunakan untuk queue.
Celery menjalankan background processing.
Dan tentu saja ada web server, reverse proxy, deployment pipeline, logging, security dan monitoring dasar.
Kemudian saya mulai memasukkan CI/CD.
Karena kalau setiap deploy harus:
SSH
cd project
git pull
docker compose ...
restart
terus-menerus...
lama-lama capek juga. 😂
Jadi deployment mulai diarahkan melalui pipeline.
Code push.
CI menjalankan test.
Build.
Deploy.
Restart service.
Verify.
Dan tentu saja...
kadang pipeline gagal juga.
Namanya juga development.
Security Became Part of the Product
Begitu mulai berpikir tentang data kandidat, saya sadar:
Ini bukan sekadar aplikasi upload PDF.
CV berisi data pribadi.
Maka security tidak bisa dianggap sebagai fitur belakangan.
Saya mulai memperhatikan:
-
access control
-
authentication
-
file handling
-
storage
-
data retention
-
upload validation
-
system logs
-
abuse monitoring
-
separation of user data
-
failure handling
Termasuk satu pertanyaan:
Berapa lama data kandidat harus disimpan?
Karena menyimpan data selamanya hanya karena secara teknis kita bisa melakukannya bukan berarti itu keputusan yang baik.
Hirevidence dirancang dengan prinsip bahwa data kandidat harus memiliki lifecycle yang jelas.
The Product Was Finally Starting to Look Like a Product
Di satu titik saya sadar:
Ini bukan lagi prototype.
Sudah ada:
Frontend.
Backend.
Database.
Worker.
Queue.
Authentication.
Screening pipeline.
Credit system.
Dashboard.
Deployment.
Landing page.
Dan yang paling penting:
ada user flow yang benar-benar bisa digunakan.
Di sinilah saya mulai merasa:
"Okay... mungkin ini benar-benar bisa jadi produk."
From Developer to Product Builder
Ada satu hal yang cukup saya rasakan selama membangun Hirevidence.
Menjadi developer dan membangun product ternyata dua hal yang berbeda.
Sebagai developer saya biasa bertanya:
"Bagaimana cara membuat fitur ini bekerja?"
Tetapi sebagai product builder saya harus bertanya:
"Apakah fitur ini memang dibutuhkan?"
"Apakah user memahami cara menggunakannya?"
"Apakah ini menyelesaikan masalah?"
"Apakah hasilnya bisa dipercaya?"
"Berapa biaya untuk menjalankannya?"
"Apa yang terjadi kalau user melakukan hal yang tidak kita prediksi?"
Pertanyaan-pertanyaan tersebut tidak memiliki jawaban hanya dengan menulis code.
Dan mungkin justru di situlah bagian paling menariknya.
From Days to Minutes
Salah satu tujuan utama Hirevidence adalah mengurangi pekerjaan manual yang repetitif.
Screening puluhan atau ratusan CV secara manual dapat membutuhkan beberapa hari atau bahkan satu minggu, tergantung volume dan kompleksitas pekerjaan.
Dalam skenario tertentu, Hirevidence dapat membantu menghasilkan screening awal dalam sekitar 10 menit.
Bukan berarti proses recruitment selesai dalam 10 menit.
Interview tetap membutuhkan manusia.
Verification tetap membutuhkan manusia.
Final decision tetap membutuhkan manusia.
Tetapi kalau pekerjaan awal yang repetitif bisa dipercepat secara signifikan...
recruiter bisa menggunakan waktunya untuk hal yang lebih penting.
And Finally...
Setelah cukup lama berada di balik layar...
Hari ini saya akhirnya bisa mengatakan:
Hirevidence.com is live. 🚀
Saya tidak menganggapnya sudah selesai.
Justru sebaliknya.
Ini baru versi pertama dari sesuatu yang masih akan terus berkembang.
Masih ada banyak fitur yang ingin saya bangun.
Masih ada banyak edge case yang harus diperbaiki.
Masih ada banyak hal yang ingin saya optimalkan.
Dan saya yakin akan ada banyak bug baru yang akan saya temukan. 😂
But that's okay.
Karena sekarang saya tidak lagi hanya membangun sebuah project.
Saya sedang mencoba membangun sebuah product.
What's Next?
Setelah launch, fokus saya bukan cuma menambahkan fitur sebanyak mungkin.
Saya ingin melihat bagaimana orang benar-benar menggunakan Hirevidence.
Apa yang mereka sukai?
Di mana mereka bingung?
Apa yang mereka anggap berguna?
Apa yang ternyata tidak berguna?
Dan yang paling penting:
Apakah Hirevidence benar-benar membantu recruiter melakukan pekerjaan mereka dengan lebih baik?
Karena pada akhirnya, sebuah product tidak dinilai dari seberapa banyak code yang kita tulis.
Product dinilai dari:
masalah apa yang berhasil kita selesaikan.
Welcome, Hirevidence. 👋
Jadi...
Welcome to the world, Hirevidence.
Dari sebuah pertanyaan kecil:
"Bagaimana kalau recruiter bisa melihat lebih jauh daripada sekadar isi CV?"
menjadi:
Hirevidence.com
Sebuah SaaS yang saya bangun untuk satu tujuan sederhana:
Find the candidate behind the CV.
Dan perjalanan ini...
baru saja dimulai. 🚀
Hirevidence is built by Codenest.
This post is part of the build journey behind Hirevidence — from idea, architecture, development, infrastructure, testing, to launch.
Tags:
Butuh Jasa Pengembangan Web?
Konsultasi gratis! Kami siap membantu mewujudkan ide Anda menjadi aplikasi web yang profesional dan berkualitas.
Konsultasi via WhatsApp